Nashnova 深度研究
AI 金融研究能直接用吗?蚂蚁百灵 Ling 模型的框架、计算与数据源实测
一份估值报告,核心财务数据、DCF、敏感性分析、风险提示一应俱全,距离“可以交付”还有多远?
这次,我们检查了 Ling-3.0-flash-Fin 在 nashnova Agent 环境下的386道金融任务。全部回答均已完成证据评测;随后,我们筛选16道候选案例,复算关键数字,并对正文采用的外部事实回查一手来源。
结论有两条。
第一,Ling能够提供有用的研究框架,但框架完整,仍不足以保证关键计算可靠。 在两道可直接复算的题目中,问题已经影响每股估值、单车利润和情景变化的判断。
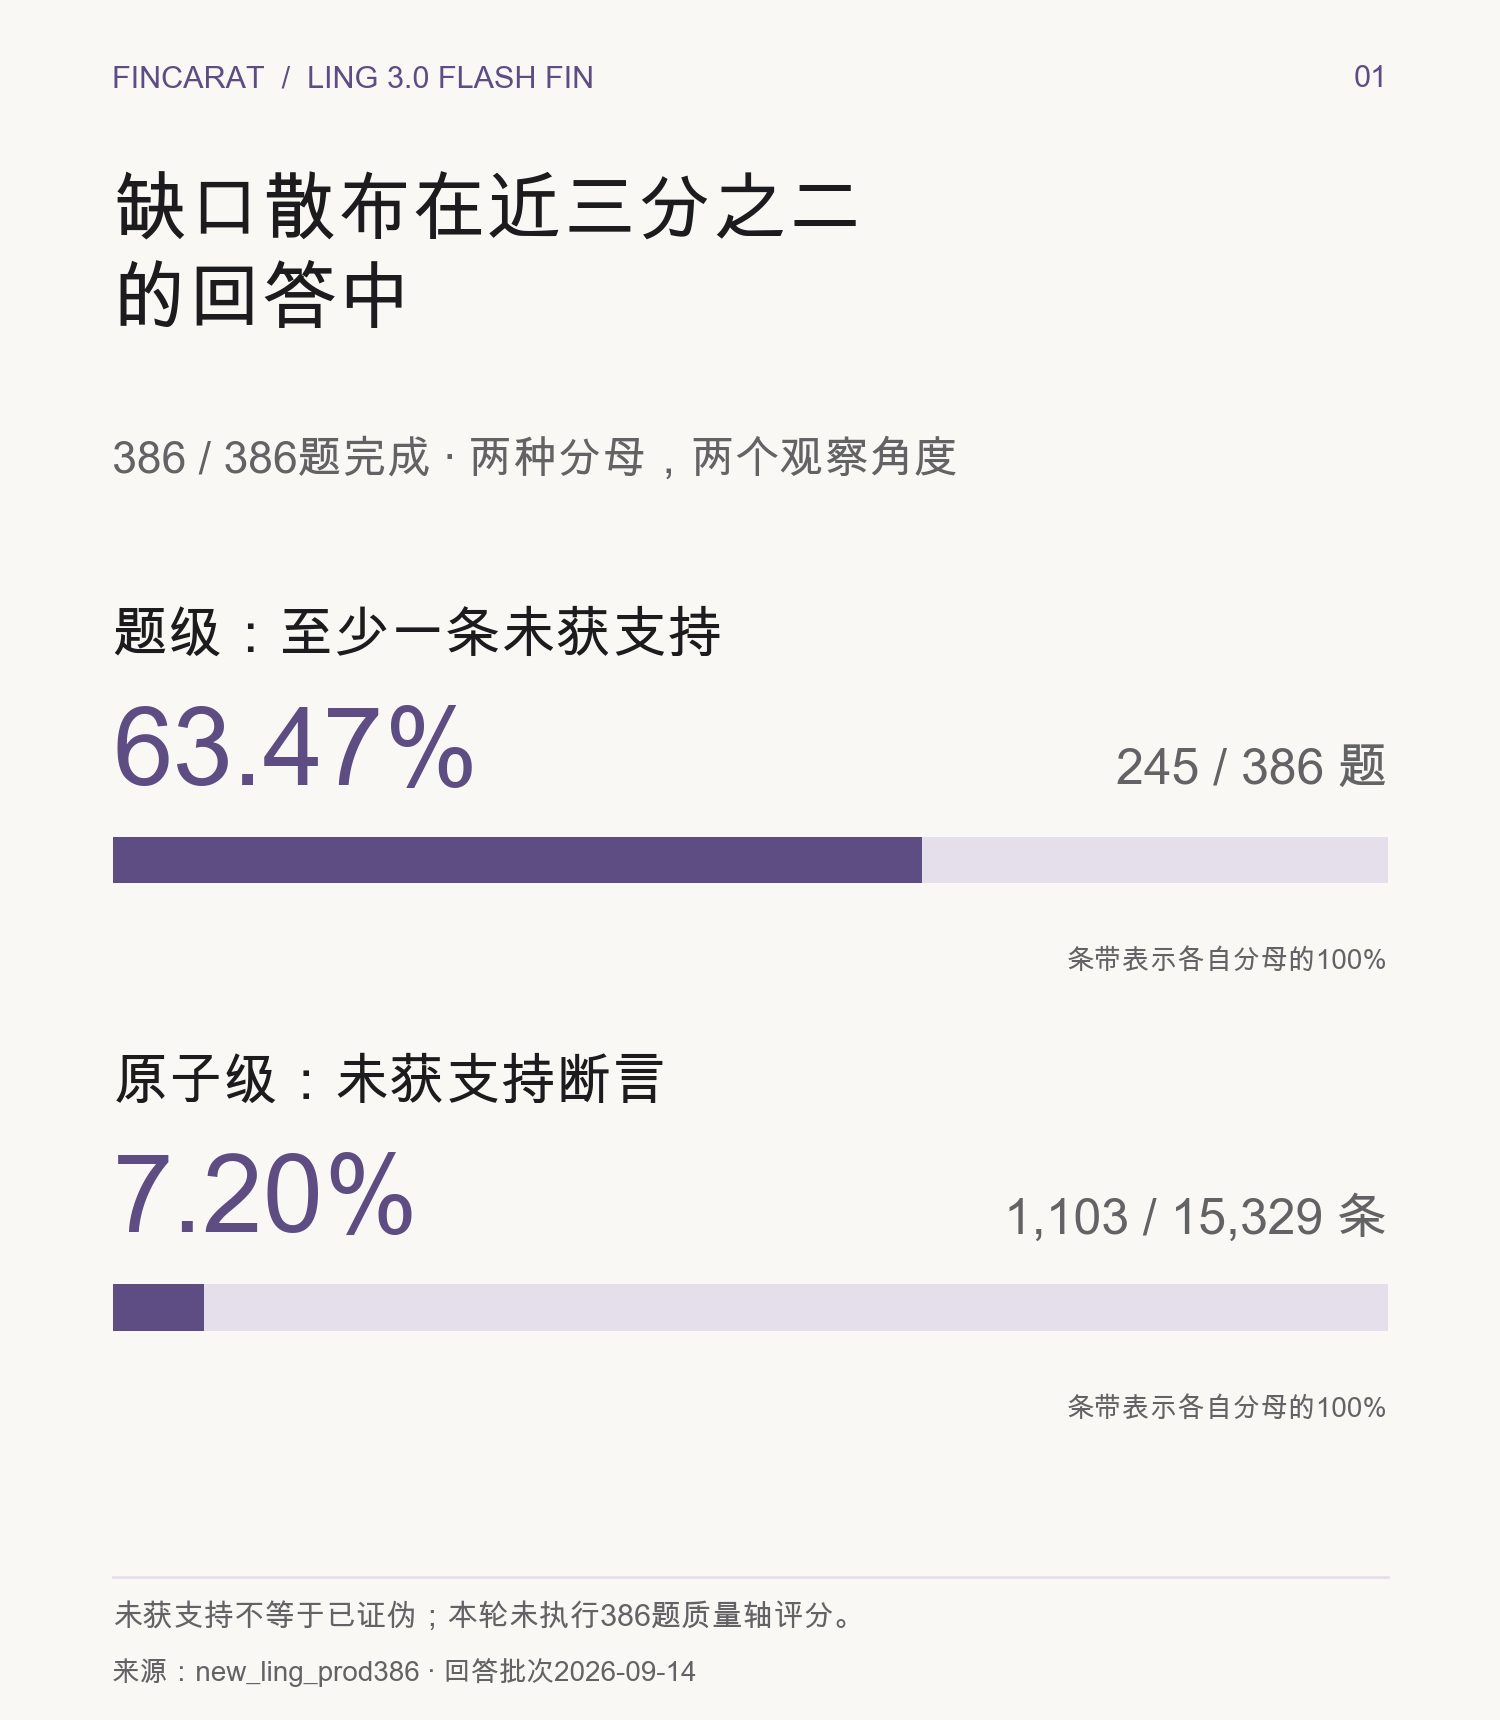
第二,63.47%值得关注,但必须读对。 这是“至少含一条未获支持断言的回答”占比,并非63.47%的全部内容都错了。更值得追问的是:缺口落在旁枝末节,还是决定结论的关键位置?
01|先读懂63.47%,再评价模型
本轮386份回答被拆成15,329条原子断言。其中,1,103条未获综合支持,原子级比例为7.20%;这些断言分布在245份回答中,形成题级的63.47%。两者不矛盾:局部缺口也可能广泛分散在不同回答里。
这里的“支持”有特定规则:评测检查回答生成时取得的工具证据,以及外部事实证据;两条路径任一支持,即记为综合支持。未获支持可能是事实矛盾,也可能是没有核实,甚至涉及明确提出的建模假设,不能一概称作编造。反过来,有工具依据也不保证数据本身正确。
因此,本文把它称为证据缺口率。本轮没有386题质量轴评分,我们不会据此给出投研能力总分或综合排名。
从样本数不少于10题的原始任务类别看,“比较与筛选”为29/38,“公司基本面与财报”为40/62。缺口并未局限在某一种任务;但各类题目难度和回答长度不同,雷达图向外越高,代表含缺口的回答越多,并非能力越强;多边形面积也不代表总分。
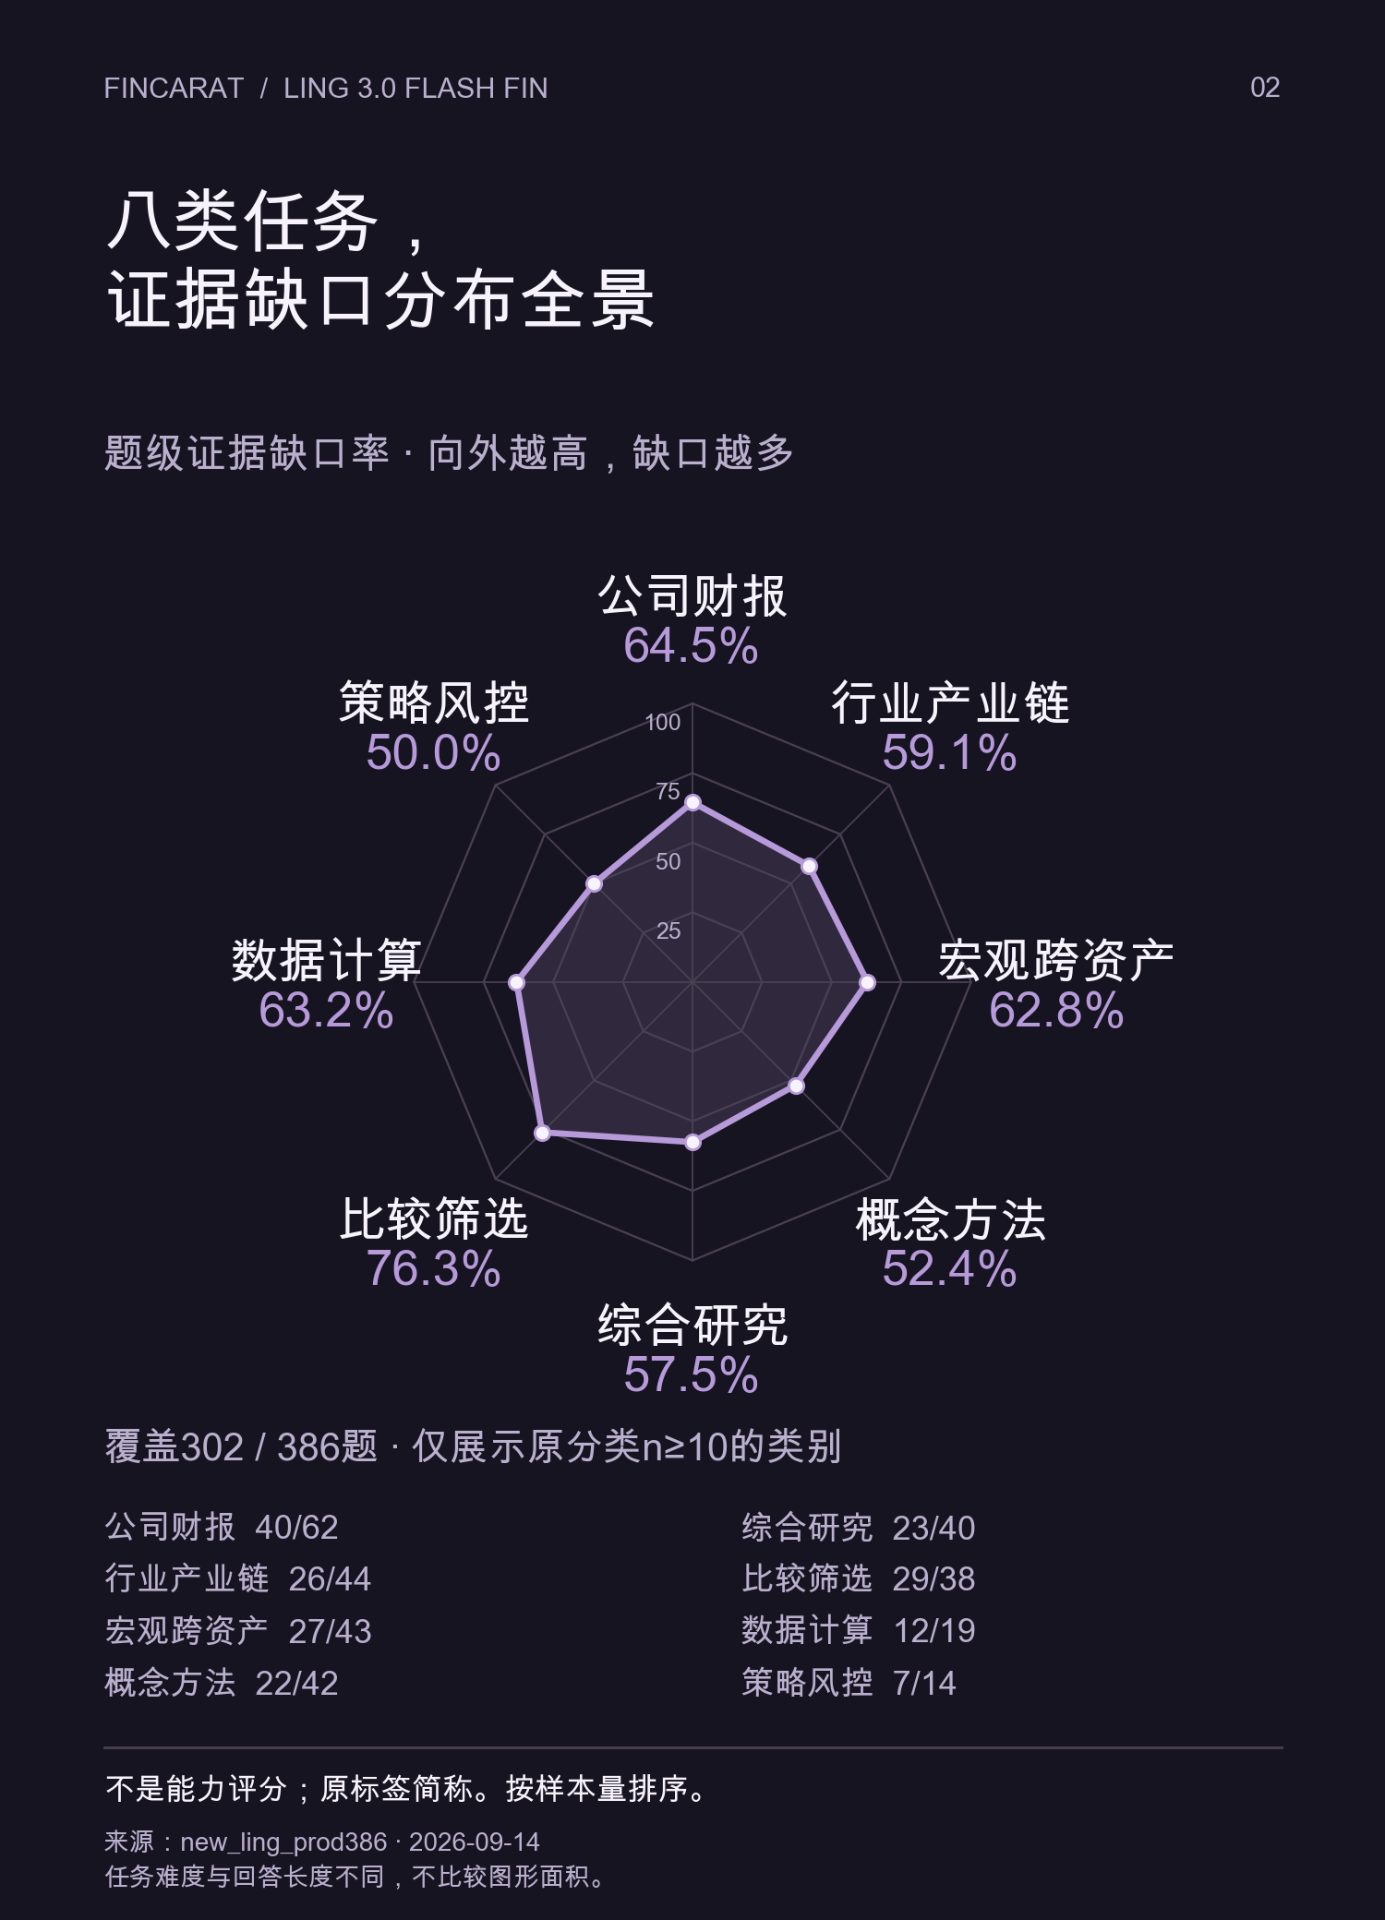
长回答更容易触及“至少一处缺口”,长回答也会贡献更多原子。总体比例回答的是问题分布,下面的案例才帮助判断问题性质。
02|做得好的地方:先检查研究框架
案例一:用什么指标研究融资租赁的“供、需、价”?
用户提出:用LPR观察价格,用社融和制造业PMI观察需求,请模型检查思路并补充指标。
Ling没有只扩写这套框架。它先指出供给侧缺失,再提醒:LPR更多反映银行信贷定价,租赁定价还受资产风险、期限和承租人信用影响;社融是宏观变量,还应加入固定资产投资、设备更新等更贴近业务的观察项。随后,它把资金与资本、设备需求、租赁收益率分成三组。
值得肯定的是,它检查了“指标能否代表研究对象”,而不只是列出更多指标。 LPR作为银行贷款定价参考的定位,也能在银行官方说明中得到核对。
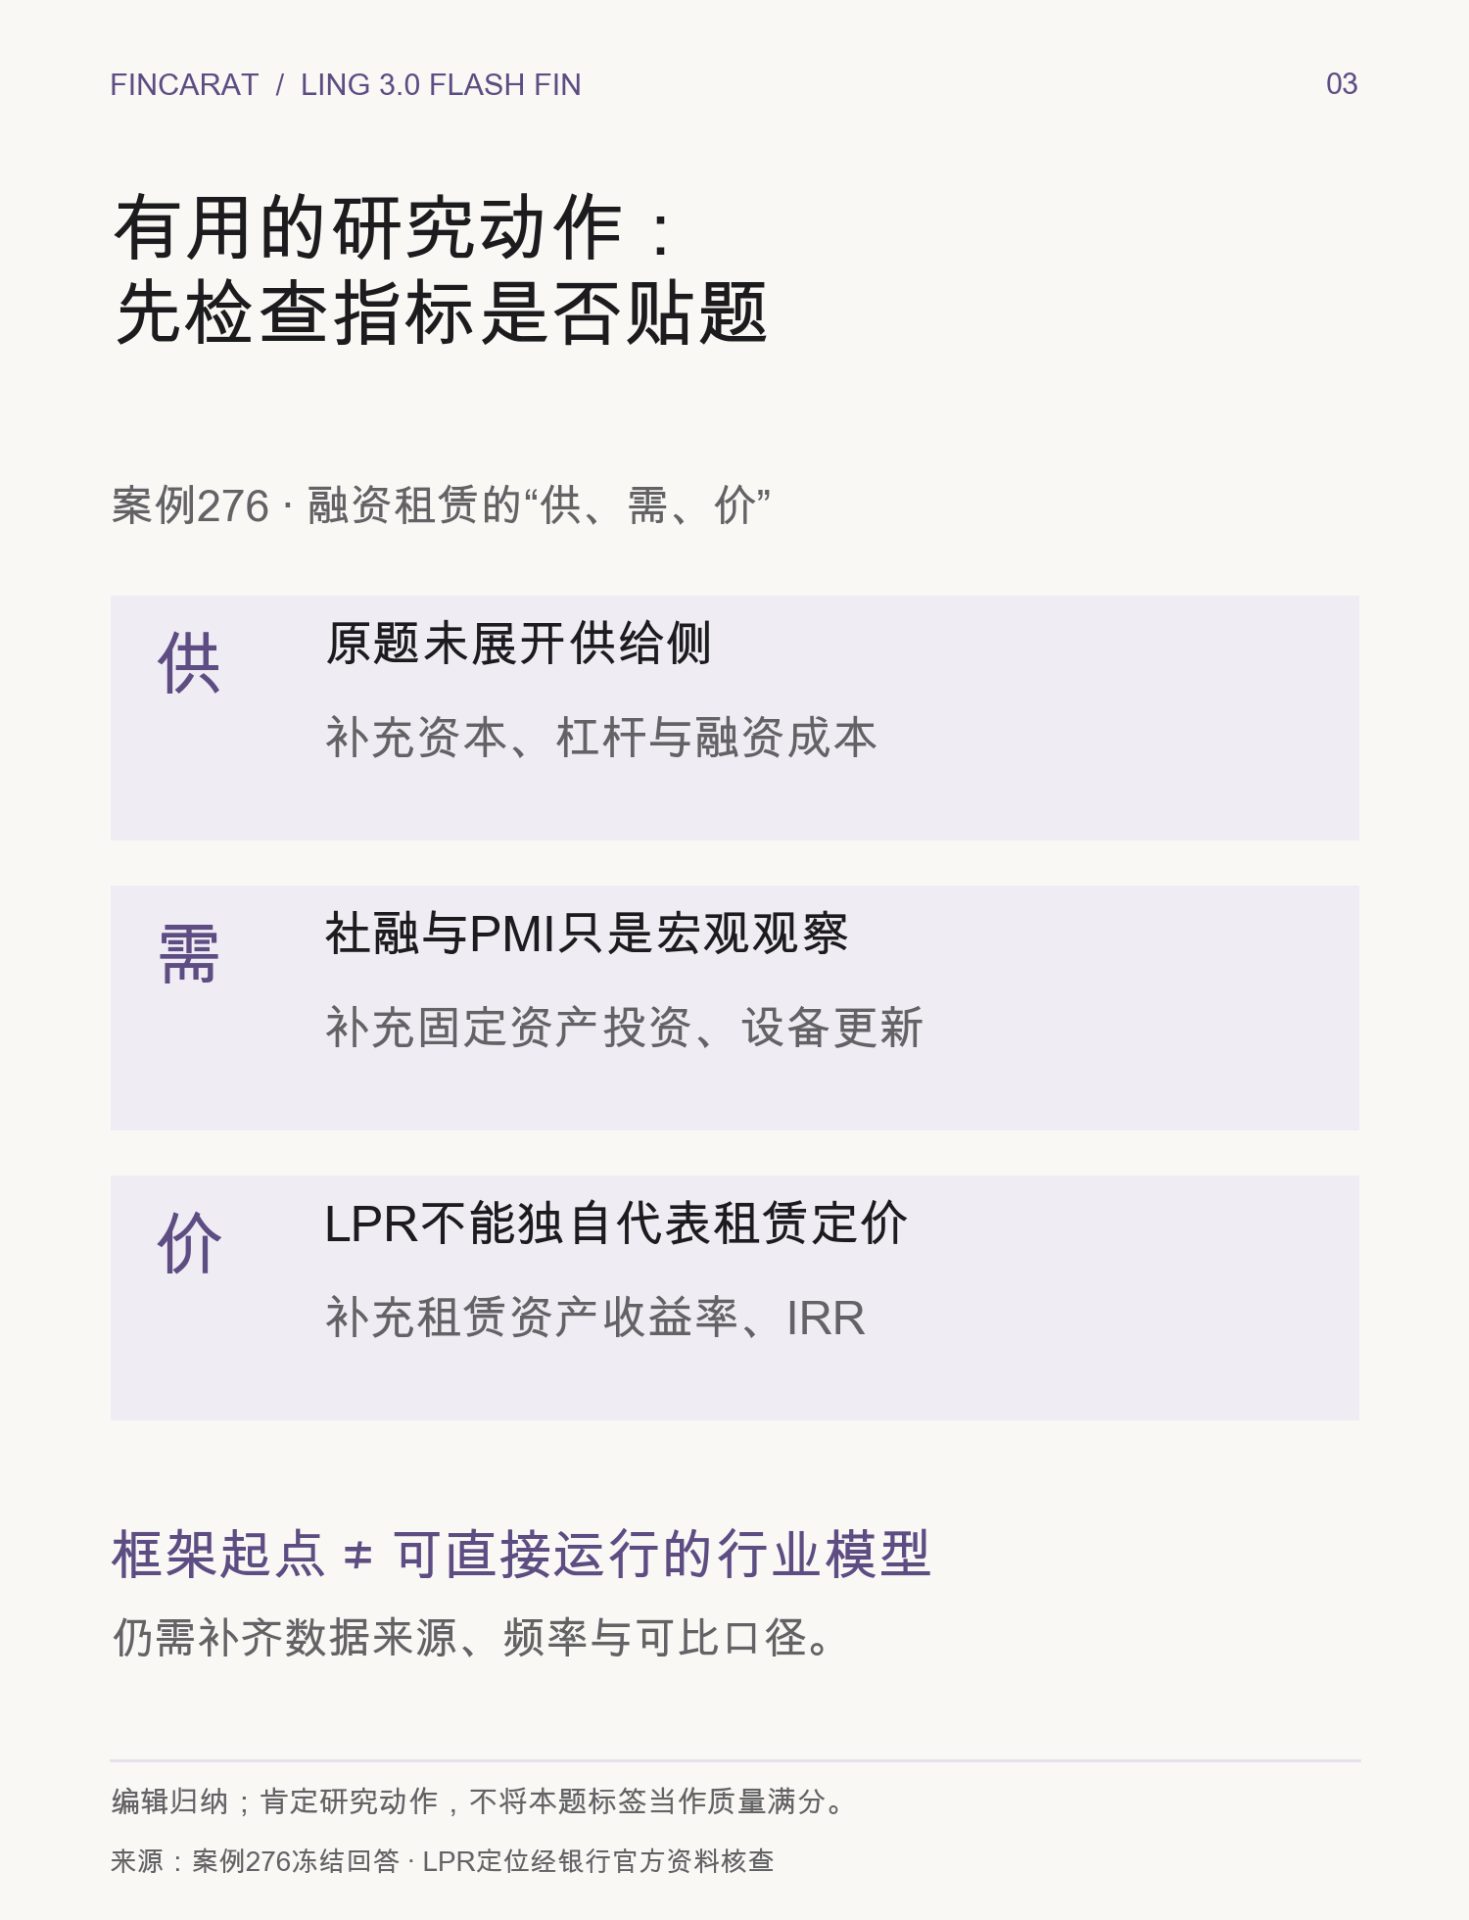
这份答案仍只是一个有用的起点。它没有给出完整数据来源、频率和可比口径;将社融直接称为“融资需求”也不够严谨。央行定义的是实体经济实际获得的资金,并非尚未满足的需求。因此,我们肯定它纠正代理指标、补齐框架的动作,不把这一题包装成行业研究已经完成。
03|第一道硬伤:DCF齐了,数字没有对齐
案例二:做一下海天味业的DCF估值。
这份回答外观相当完整:财务数据表、现金流预测、折现因子、终值、每股价值和敏感性矩阵都有。仅按“有没有写到”检查,很容易放行。
但原文给出这样的计算:
每股内在价值 ≈ 153.86亿 / 55.6亿股 ≈ 27.7元/股
相同单位相除,153.86÷55.6约等于2.77,并非27.7。这是可以直接复现的算术不一致,无须先争论增长率是否乐观。
问题还没有结束。在WACC为8%、终端增长率为3%的同一组参数下,第三节给出27.7元,敏感性表的基准格和最后的结论却给出22.7元。同一份报告存在两个未作解释的基准估值。
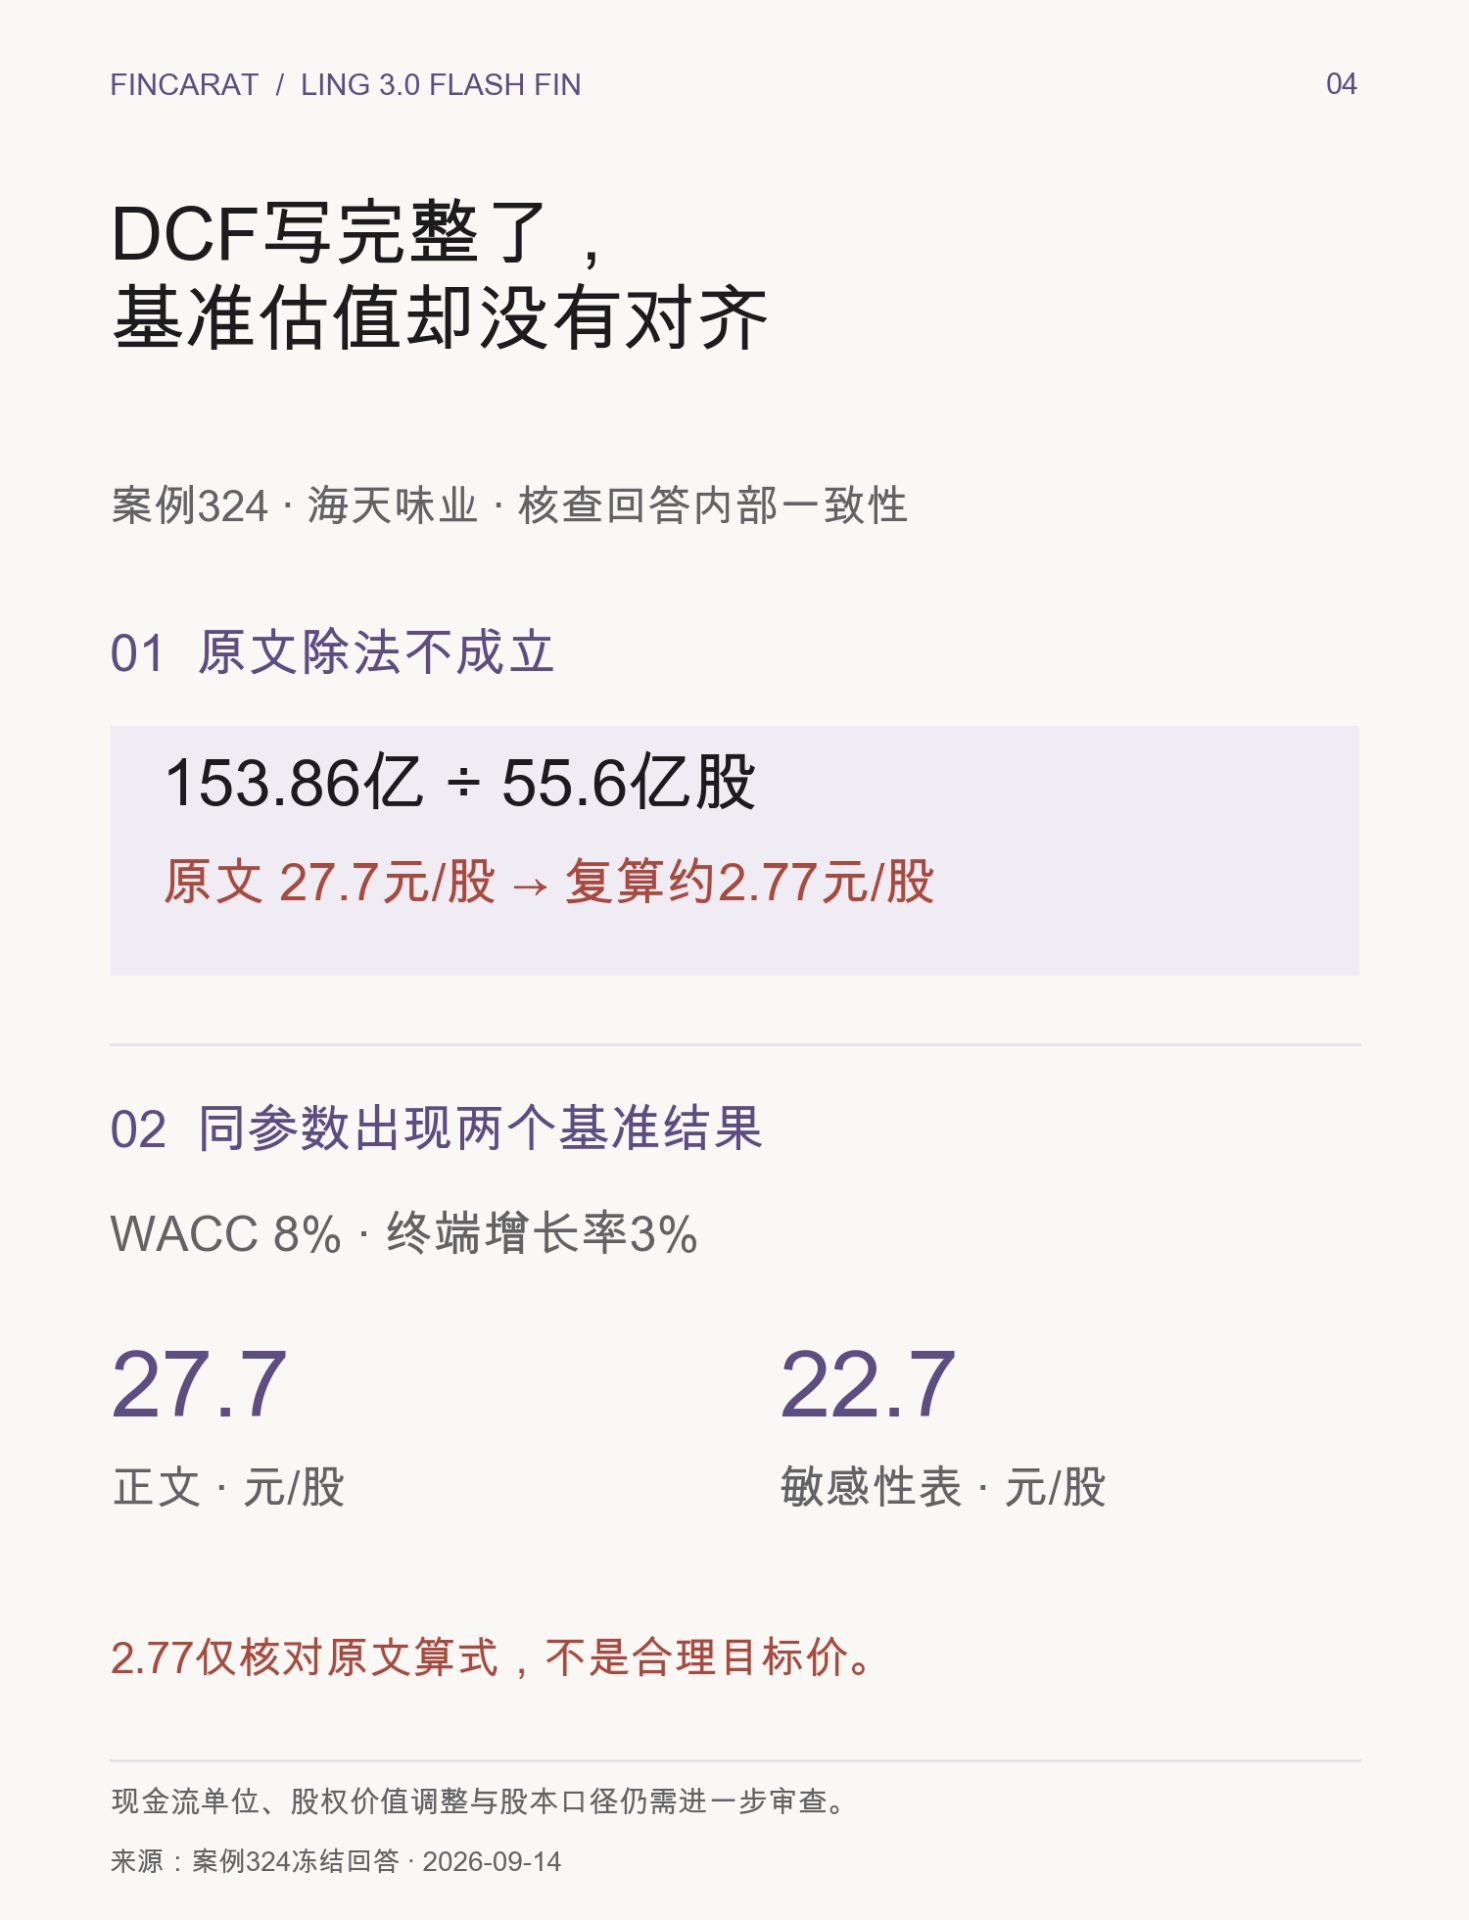
真正伤及交付的,是读者无法沿着输入、公式、表格,复现一个一致的结论。 敏感性分析本应用来检查结果稳健性,在这里却产生了新的矛盾。
需要强调,2.77元只是核对原文除法的结果,绝不是我们给出的合理目标价。现金流单位、企业价值到股权价值的调整、股本口径仍需重新审查。
同样,这题49条原子中有32条未获支持,也不能写成“32处事实造假”:其中5条是明确的建模假设。我们的批评落在可复算的算术与一致性问题上,而不是把设定假设本身当成错误。
04|第二道硬伤:公式正确,情景方向仍会算反
案例三:计算Q2混合单车净利润。
这道题给出了国内传统、海外、国内二代三组销量,分别为42.69、47.11、21万辆,并列出五组单车利润。按Ling自己采用的解释,每一行是一个情景,统一按销量加权。
它列对了公式,第一情景也算对了。但第五情景的三组单车利润为5,563、11,126、7,000元,独立复算得到:
(42.69×5,563+47.11×11,126+21×7,000)÷110.8 ≈ 8,200.63元/车。
模型给出的却是12,800.63元/车,偏高约56.09%。
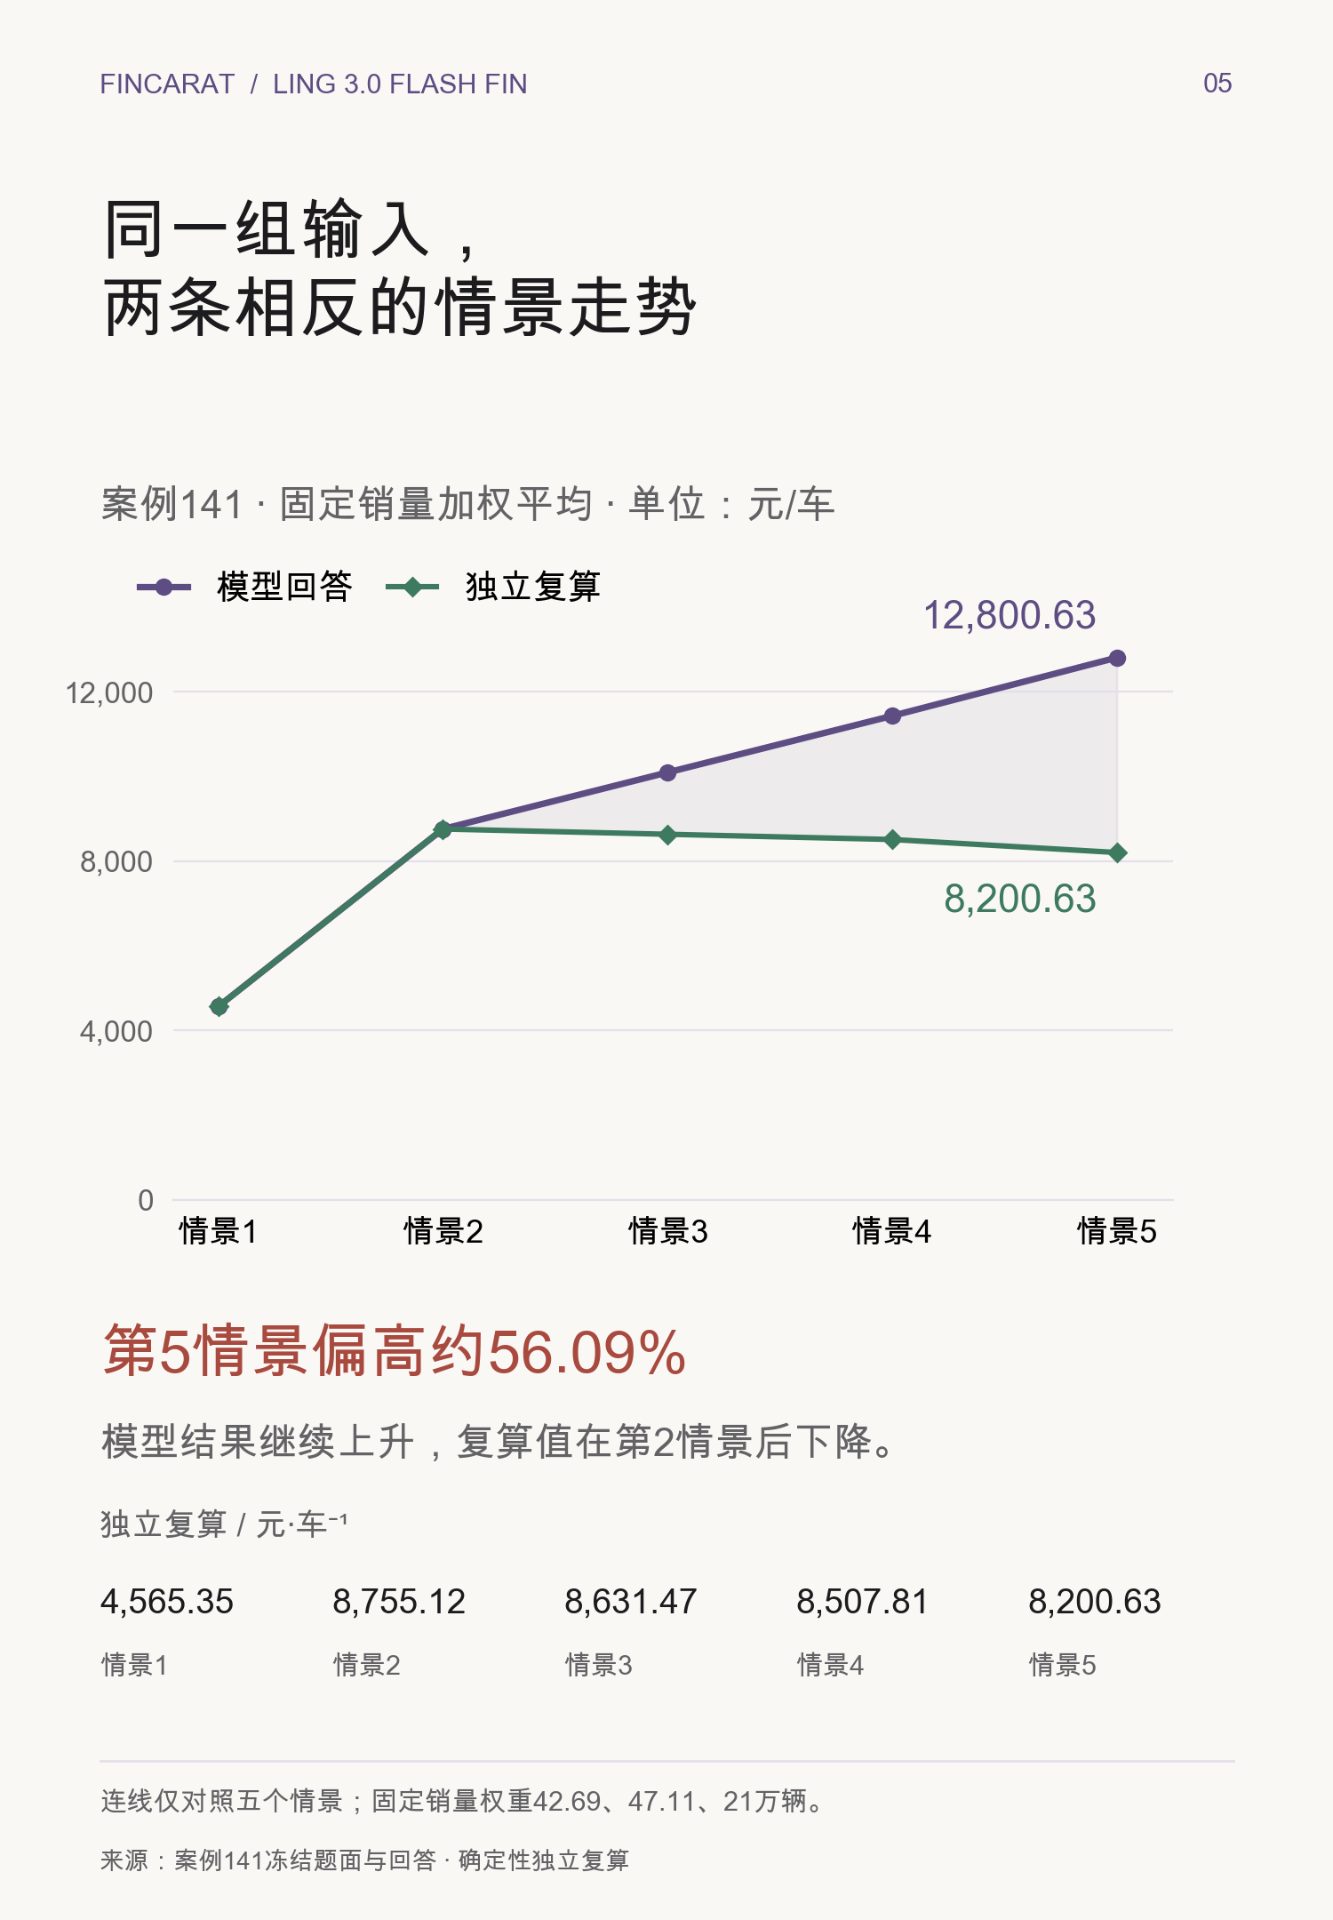
这不只是小数误差。模型把后续情景描述为越来越高,正确序列却在第二情景后逐步下降。如果把这些结果继续用于盈利预测,连情景变化方向都会受到影响。
为公平起见,第二情景仅相差约0.19元,不应与第五情景约4,600元的偏差作同等渲染。这里最有说服力的发现是:展示正确公式,并不能替代实际执行和检查计算。
05|更隐蔽的一层:答案有依据,依据也可能错
案例四:中海油近三年的自由现金流。
这题20条原子全部获得综合支持,看起来应是一个正例。但展开双轴结果,会看到多项事实轴冲突,因为工具返回能够支撑原回答,它们仍按OR规则计为综合支持。
我们进一步回查了中海油2023年年报。其合并现金流量表列示:经营活动现金流入净额为209,743百万元,资本支出为120,875百万元。沿用回答自己的“经营现金流减资本支出”口径,得到888.68亿元;答案写的是923.82亿元。
公司同期业绩公告披露自由现金流约888.7亿元,也与上述计算吻合。
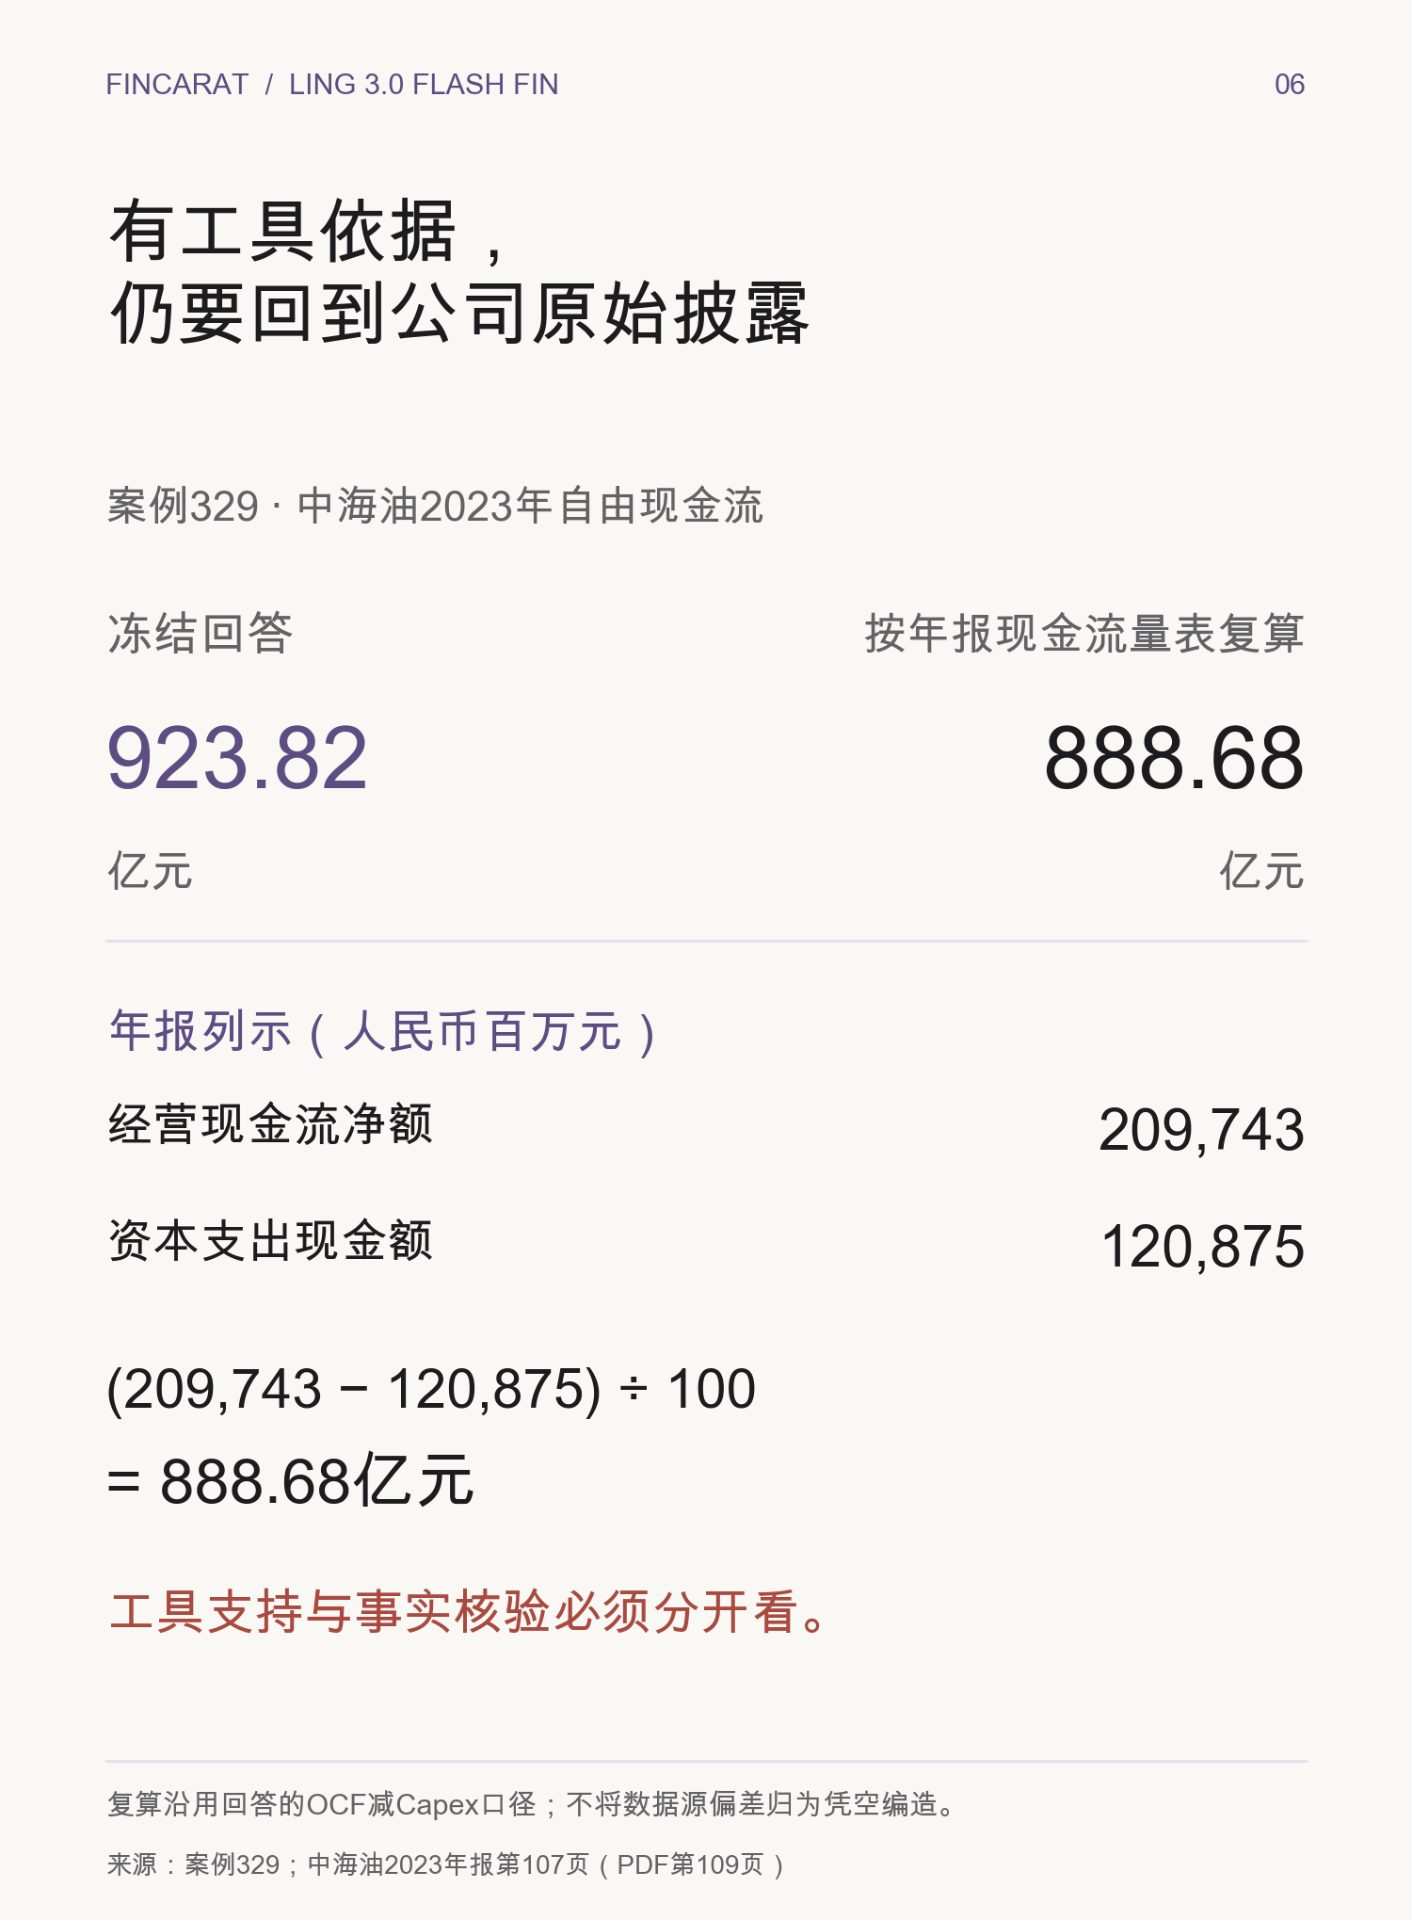
这个案例不能简单归咎于Ling凭空编数。冻结审计保留的工具证据表明,答案沿用了数据源的数值。它说明的是:金融研究的交付可靠性,必须覆盖数据源、模型处理和最终核验整条链。 忠实转述错误数据,依然会得到错误结果;“零证据缺口”也不能当作事实正确率100%。
06|我们会怎样使用这套模型
基于这轮结果,我们愿意让Ling参与研究草稿:检查问题拆分是否完整,提出候选指标,整理需要继续验证的路径。融资租赁案例展示了这类工作的价值。
但涉及估值、利润和现金流时,我们不会省略三道检查:关键输入回到公司披露并对齐主体、期间和单位;数字交给可复现程序计算;最后检查正文、表格和结论是否一致。数据来自工具,也要保留回查原始来源的入口。
本轮没有做成本收益实验,不能据此判断它是否最划算;没有完整质量轴和严格控制的横向对比,也不宜宣布它全面领先或落后。四个精选案例用于解释机制,不代表这些机制在386题中的发生频率。
这次实测的判断是明确的:Ling能够帮助搭建金融研究框架,但把框架变成可交付结论,关键数字仍需要逐项复核。 最值得建立的信任,不是“它写得像不像研究报告”,而是读者能否顺着证据和计算,把结论重新做出来。